教程
AI漫剧人物三视图提示词:从一张照片到整套角色设定
人物三视图、四视图的提示词怎么写,怎么把脸、身材、衣服、道具分开做再组合成角色设定卡,再加一张姿势图出成品画面。每一步都附提示词和结果。
文章目录
做AI漫剧,最常见的麻烦是人物不稳:第一个镜头是一张脸,换个镜头又是另一张,衣服的颜色和款式也跟着变。
办法是先做一张人物三视图。把这个角色的正面、侧面、背面定在一张图上,后面每个镜头都拿它当参考图,模型就有了照着画的依据。
这篇从最简单的做起,一步步加东西:一张照片出人物三视图,纯文字出四视图,三张图合成一个角色,再把衣服和道具也拆开做,最后加一张姿势图,出一张成品画面。每一步都有提示词。
准备
- 打开CVY.AI的图片生成器。只用文字就选文字生成图片,要上传图片就选图片生成图片。
- 一次最多可以放10张参考图。提示词里说的「图1、图2」,就是参考图从左到右的顺序,顺序不对可以拖动调整。
- 模型:前三步用的是GPT Image 2,分辨率选2K;机车角色那两步用的是GPT Image 2.6 Sunburst。
- 比例按每一步写的选。
第1步:一张照片出人物三视图
先要有一张定好的人物照。可以是你自己画的角色,也可以先用文字生成一张。我们这张是文字生成的半身照。
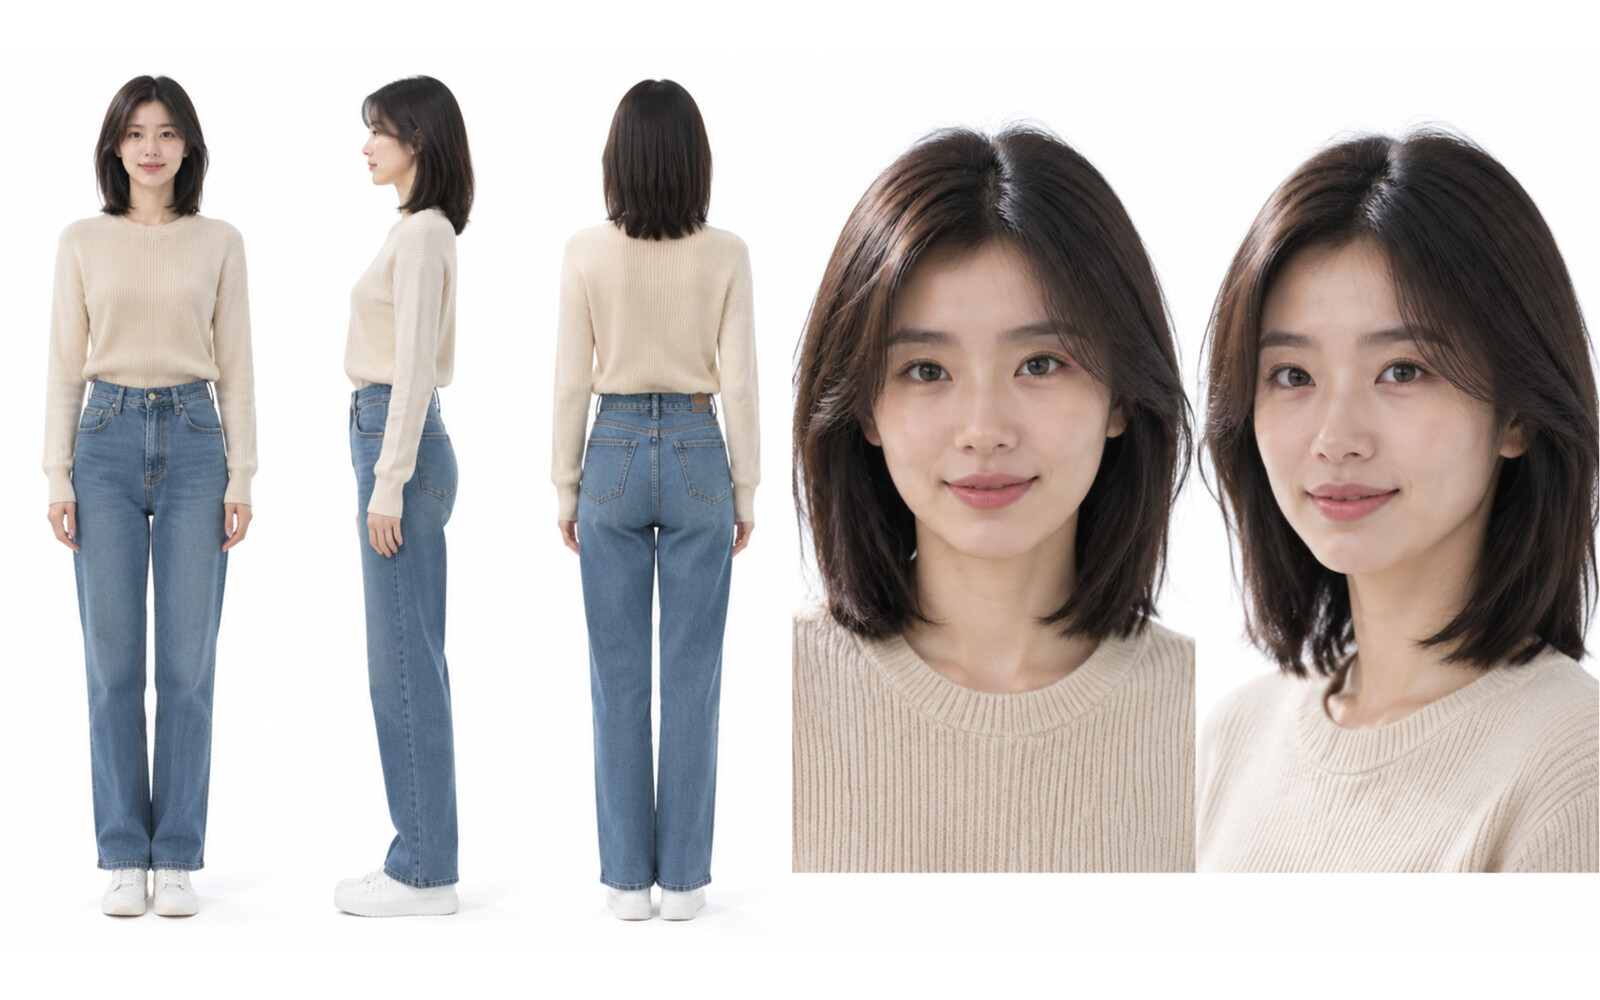
选图片生成图片,把这张照片放进参考图,比例选16:9,提示词:
请以上传的照片作为唯一的人物参考,生成同一位人物的角色设定图:左侧是全身三视图,依次为正面、侧面、背面,统一直立站姿,双臂自然下垂;右侧是五官特写,包含正脸和四分之三侧脸。脸型、五官、发型、发色、服装与参考照片保持一致。纯白背景,柔和均匀的棚拍光,写实摄影质感,高清。画面中只出现这一位人物,不要文字、标签、箭头、道具和场景。
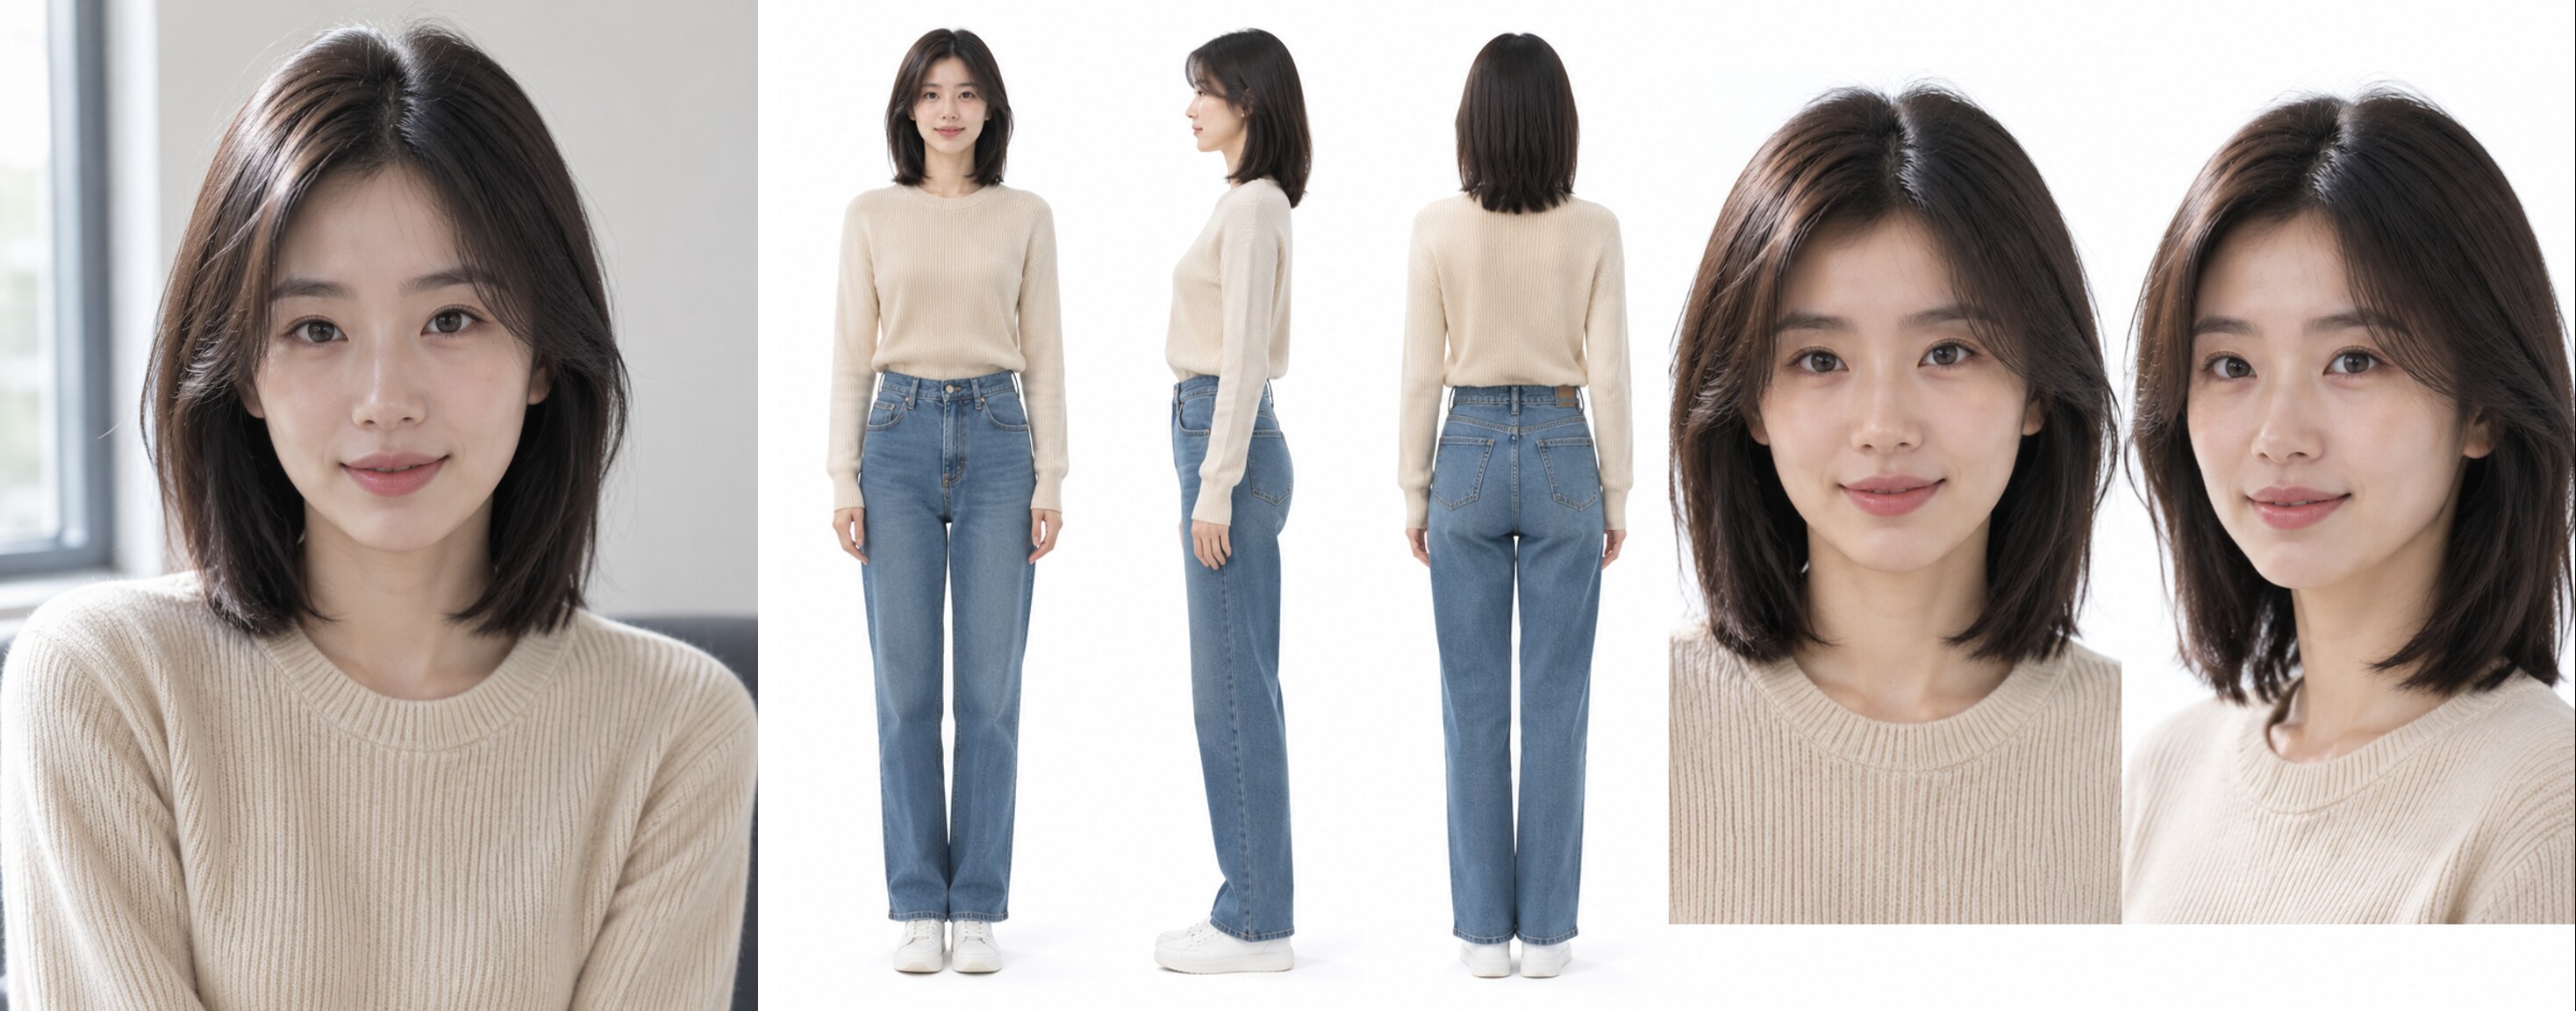
脸、发型和上衣都跟参考照片对得上。16:9的画面,一排刚好放下三个全身和两张特写。
有一点要知道:我们的参考照只有半身,裤子和鞋是模型自己配的。想要指定的下装,要么参考照拍全身,要么在提示词里写出来。
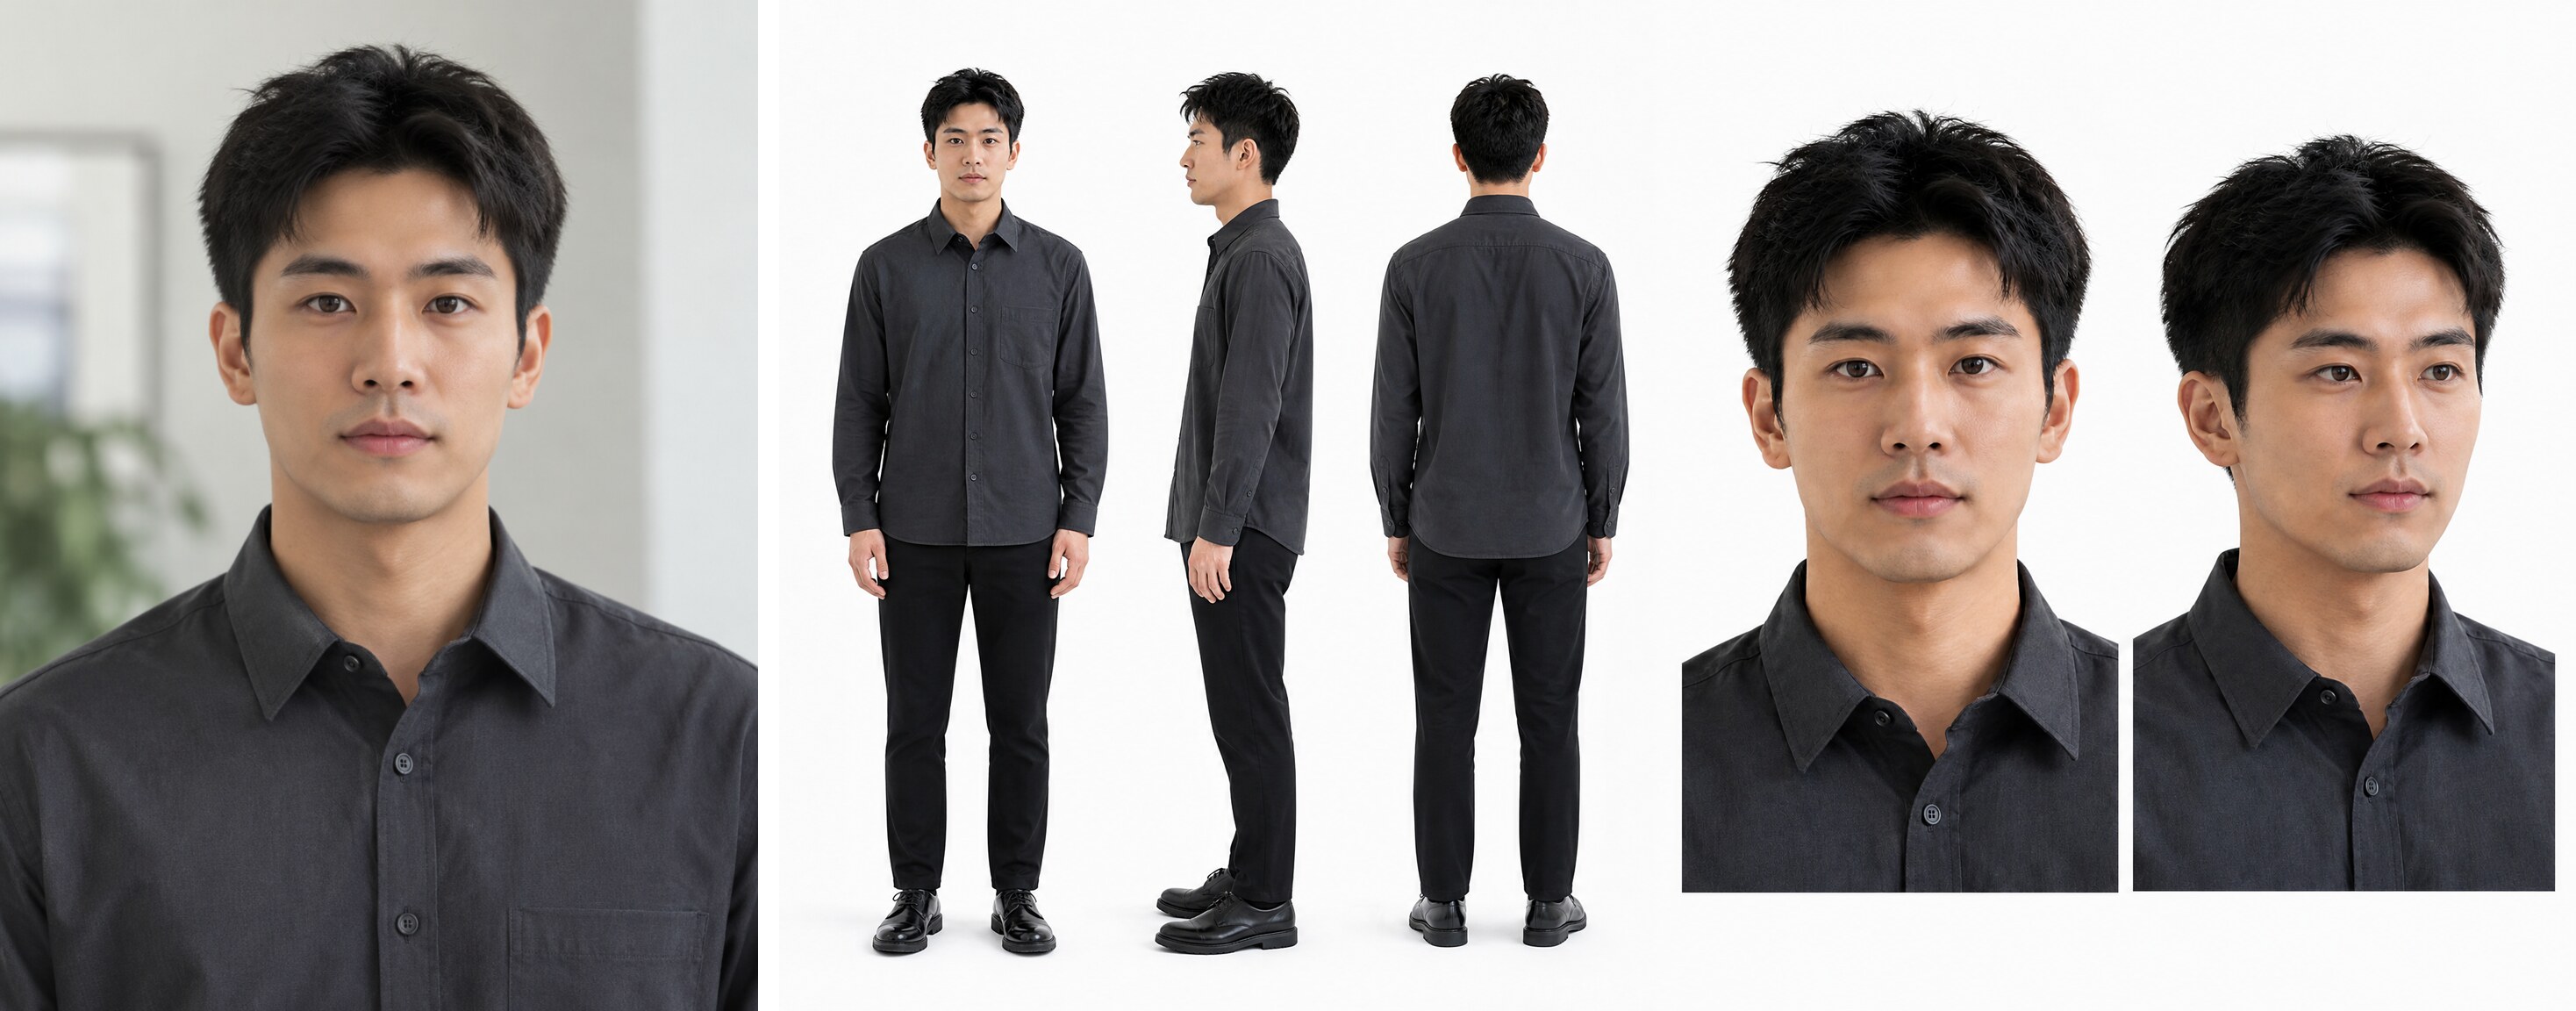
换一张男生的照片,同一段提示词一个字不改,也能用。
第2步:没有照片,纯文字出四视图
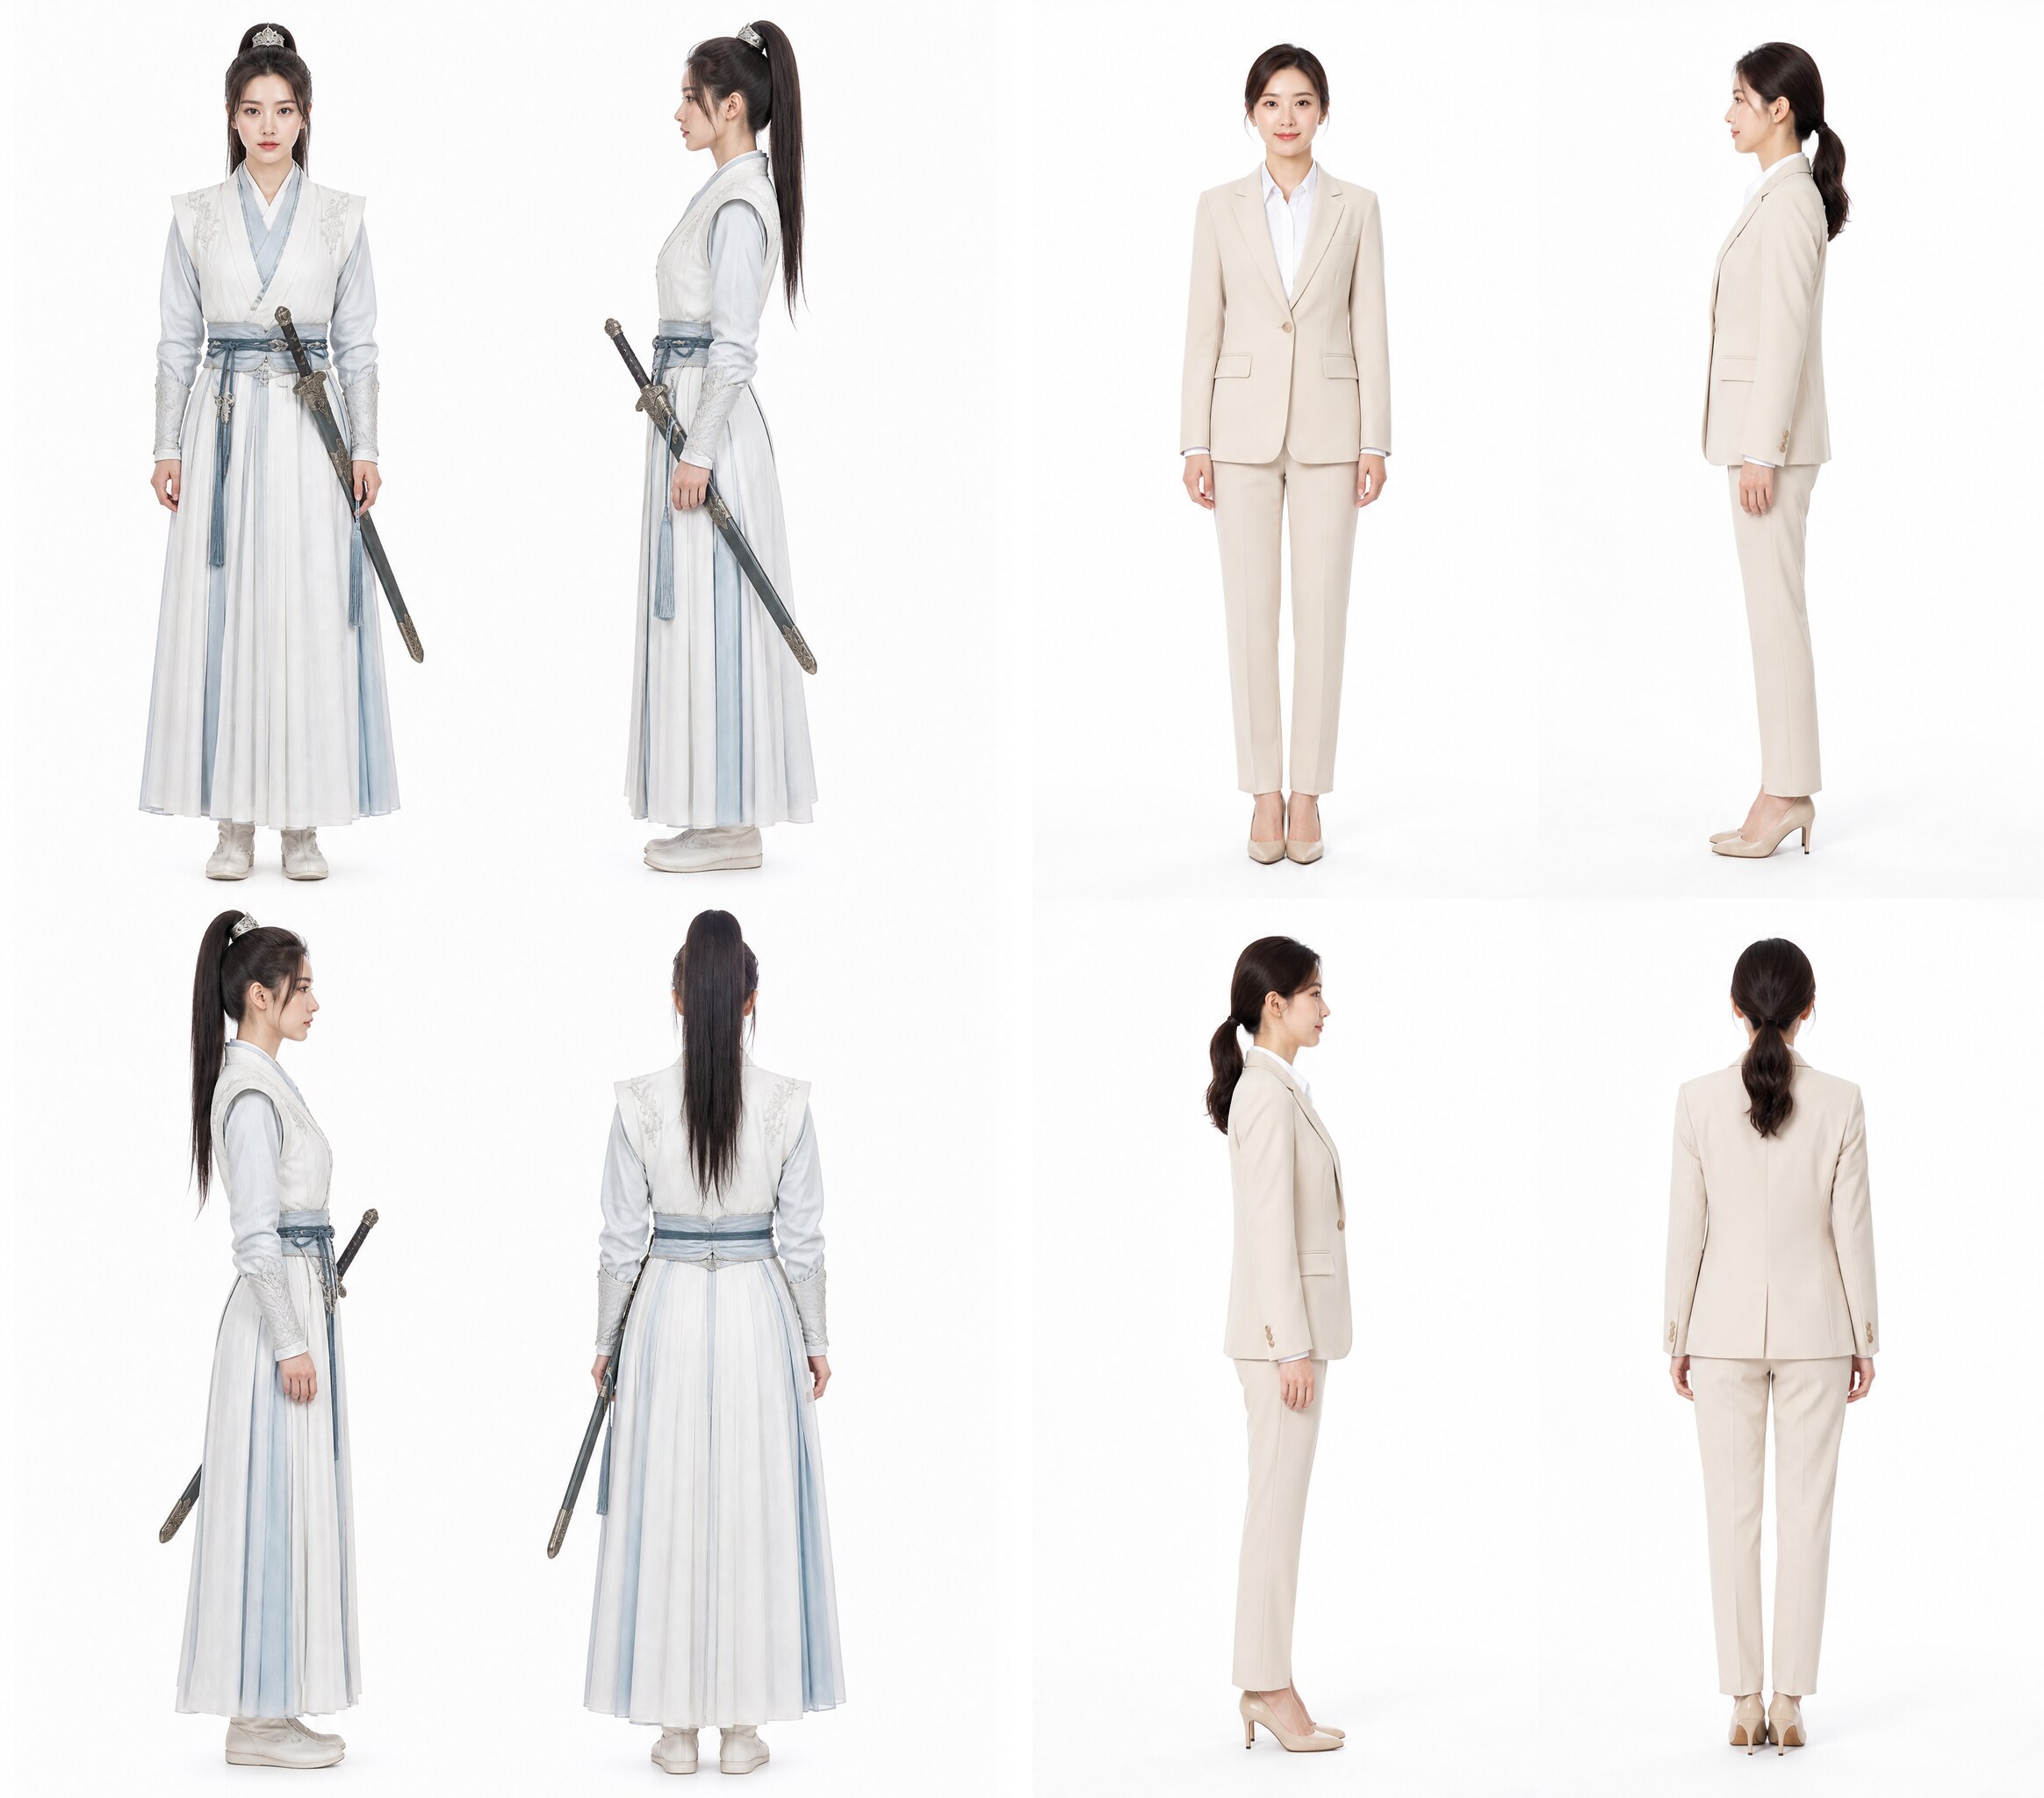
如果角色还只在脑子里,可以不用参考图,直接用文字出四视图。竖屏漫剧用9:16,一张图上下两排:正面、左侧面、右侧面、背面。
选文字生成图片,比例选9:16,提示词:
角色四视图,竖版构图,分上下两排、每排两个视角:正面、左侧面、右侧面、背面。同一位角色,统一直立站姿,身高比例一致,服装和发型在四个视角里完全一致。角色:〔角色描述〕。纯白背景,柔和均匀的棚拍光,〔画风〕,高清。不要文字、标签、箭头和场景。
换角色只改「角色:」后面那一句,画风按题材换。下面两张填的分别是:
- 24岁的古风女剑客,高马尾,青白色劲装,腰间佩剑。画风:写实影视剧定妆照质感。
- 26岁的都市职场女性,低马尾,米色西装外套配白衬衫和西裤。画风:写实摄影质感。
第3步:脸、身材、画风分开定,三张图合成一个角色
到这里,一个角色的所有信息都挤在一张照片或者一句描述里。想换个身材,或者换一种画风,就得整个重来。
所以把它们拆开:一张图定脸,一张图定身材,一张图只借画风。三张一起上传,提示词里说清楚每张图取什么、不取什么。
选图片生成图片,按头像、身材、画风的顺序放进参考图,比例选16:9,提示词:
Create a character turnaround sheet for one single character, combining the reference images: the face, hair, eyes, stubble and earrings from image 1; the body build, muscles, skin tone and outfit from image 2 (shirtless, loose black jogger sweatpants with a white drawstring, white sneakers); the art style, line art, shading and lighting from image 3. Image 3 is only an art style reference: ignore its face, hair, clothing and pose, and copy only its line art, shading and lighting.
Layout: exactly four full-body views of the same man in one row, evenly spaced, all the same height and scale, feet on the same ground line, on a plain light grey background. Nothing else in the image: no face close-up, no inset, no extra figures.
View 1, FRONT: body and face facing the viewer straight on, both shoulders equally wide, both eyes and both ears visible.
View 2, 3/4: the whole body rotated 45 degrees to the viewer's left, the far shoulder clearly narrower than the near one, the far side of the chest partly hidden, face turned the same way with the far eye partly hidden by the nose bridge.
View 3, SIDE: a true 90-degree left profile of the whole body, facing the left edge of the image, only one arm, one eye and one ear visible, the chest and abs seen only as a side silhouette.
View 4, BACK: body and head facing directly away from the viewer, back muscles, shoulder blades and back of the head visible, no face visible.
Neutral standing pose in every view, arms relaxed at the sides. The face, hairstyle, body proportions and outfit must stay exactly the same in all four views. Below each view, a small clean label in a simple sans-serif font: FRONT, 3/4, SIDE, BACK. No other text, no watermark. Hands with five fingers and correct anatomy. Art style: modern Korean webtoon (manhwa) illustration, clean thin line art, soft cel shading, even soft lighting, high detail.
(我们实际用的是英文。意思是:用上传的3张参考图,生成同一个角色的四视图设定图。图1取脸、发型、眼睛、胡茬和耳钉;图2取身材、肌肉、肤色和服装;图3只参考画风,取它的线条、上色和光影,忽略它的脸、发型、衣服和姿势。构图是一排四个全身视图,身高和比例一致,脚踩同一条地平线,浅灰纯色背景,不要脸部特写和小图。接着逐个写四个视图:正面、3/4侧面、侧面、背面各自看得见什么、看不见什么。最后要求四个视图的脸、发型、身材和服装完全一致,每个视图下面写一个小标签。中文提示词也可以。)
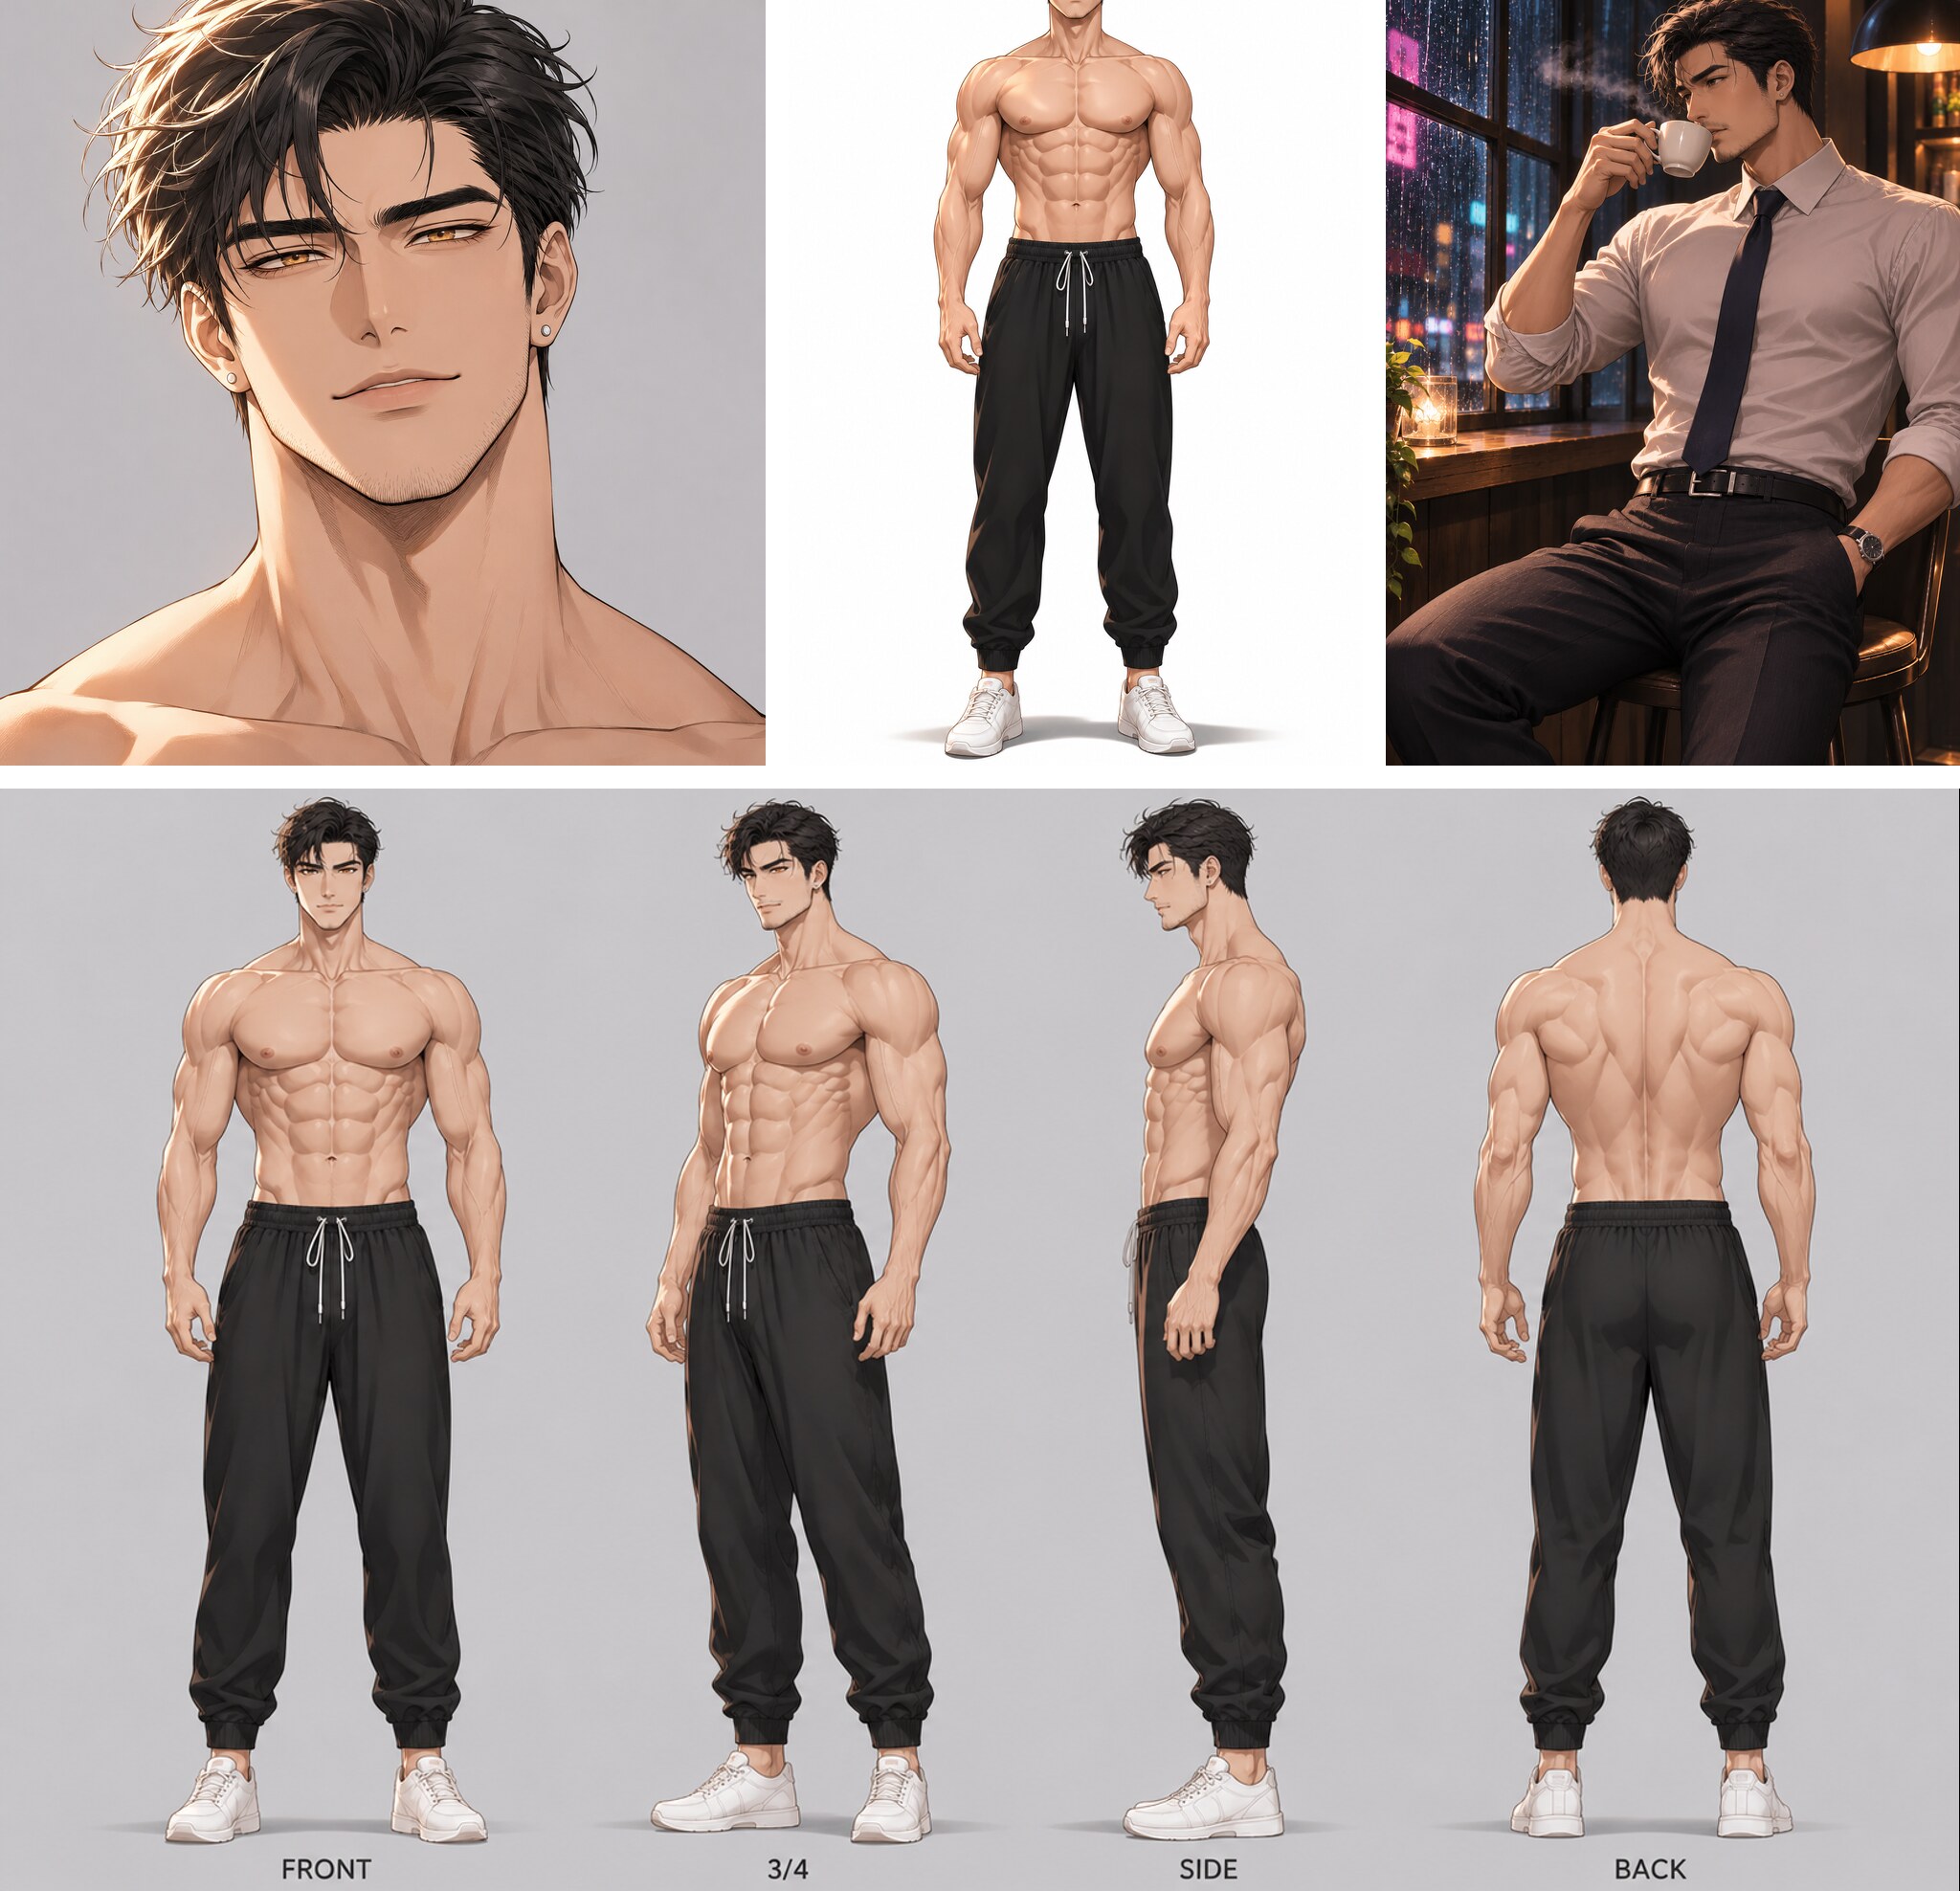
写法上有两点最管用:
- 每张图都写「取什么」和「忽略什么」。画风那张图里也有一个人,不写「忽略它的脸、发型、衣服和姿势」,他的长相就可能混进来。
- 每个视图单独写一句,说清楚这个角度能看见什么。比如侧面写「只看得见一只手臂、一只眼睛、一只耳朵」,背面写「看不见脸」。
第4步:再拆两样,衣服和道具
同样的思路可以接着拆。我们做了一个机车角色,分成四样素材:脸、身材、骑行服、摩托车。每样先出几张,用的时候各挑一张。
素材都是文字生成的,每类一个模板,结尾共用一句,画风统一写在这一句里,组合出来才不会乱:
浅灰纯色背景,不要文字和水印,任何地方都没有品牌标志和车牌号。画风:日系动漫,干净线稿,赛璐璐上色,均匀柔光,高细节。
四类素材各举一个例子:
- 脸,比例1:1:肩部以上正面头像,25岁东亚男性,黑色短发略凌乱,眉眼锋利,表情冷淡,看向镜头。
- 身材,比例3:4:全身正面站姿,双臂自然下垂,一位身高185厘米、修长偏瘦、肩宽腿长的成年男性,穿纯黑色紧身速干长袖和长裤、黑色运动鞋,戴纯黑色全盔,深色镜片,看不到脸。
- 骑行服,比例3:4:一套一体式皮质连体赛道骑行服,哑光黑为主,肩部、手臂外侧和小腿有橙色条纹,肩肘有硬质护甲,膝盖外侧有护膝滑块,配黑色手套和黑色赛车靴,穿在无头的灰色服装人台上,正面全身,从肩到脚都在画面里。
- 摩托车,比例4:3:一辆哑光黑配橙色细线的全包围运动跑车,正侧面全车,车头朝画面左边,停在地面上,画面里没有人。
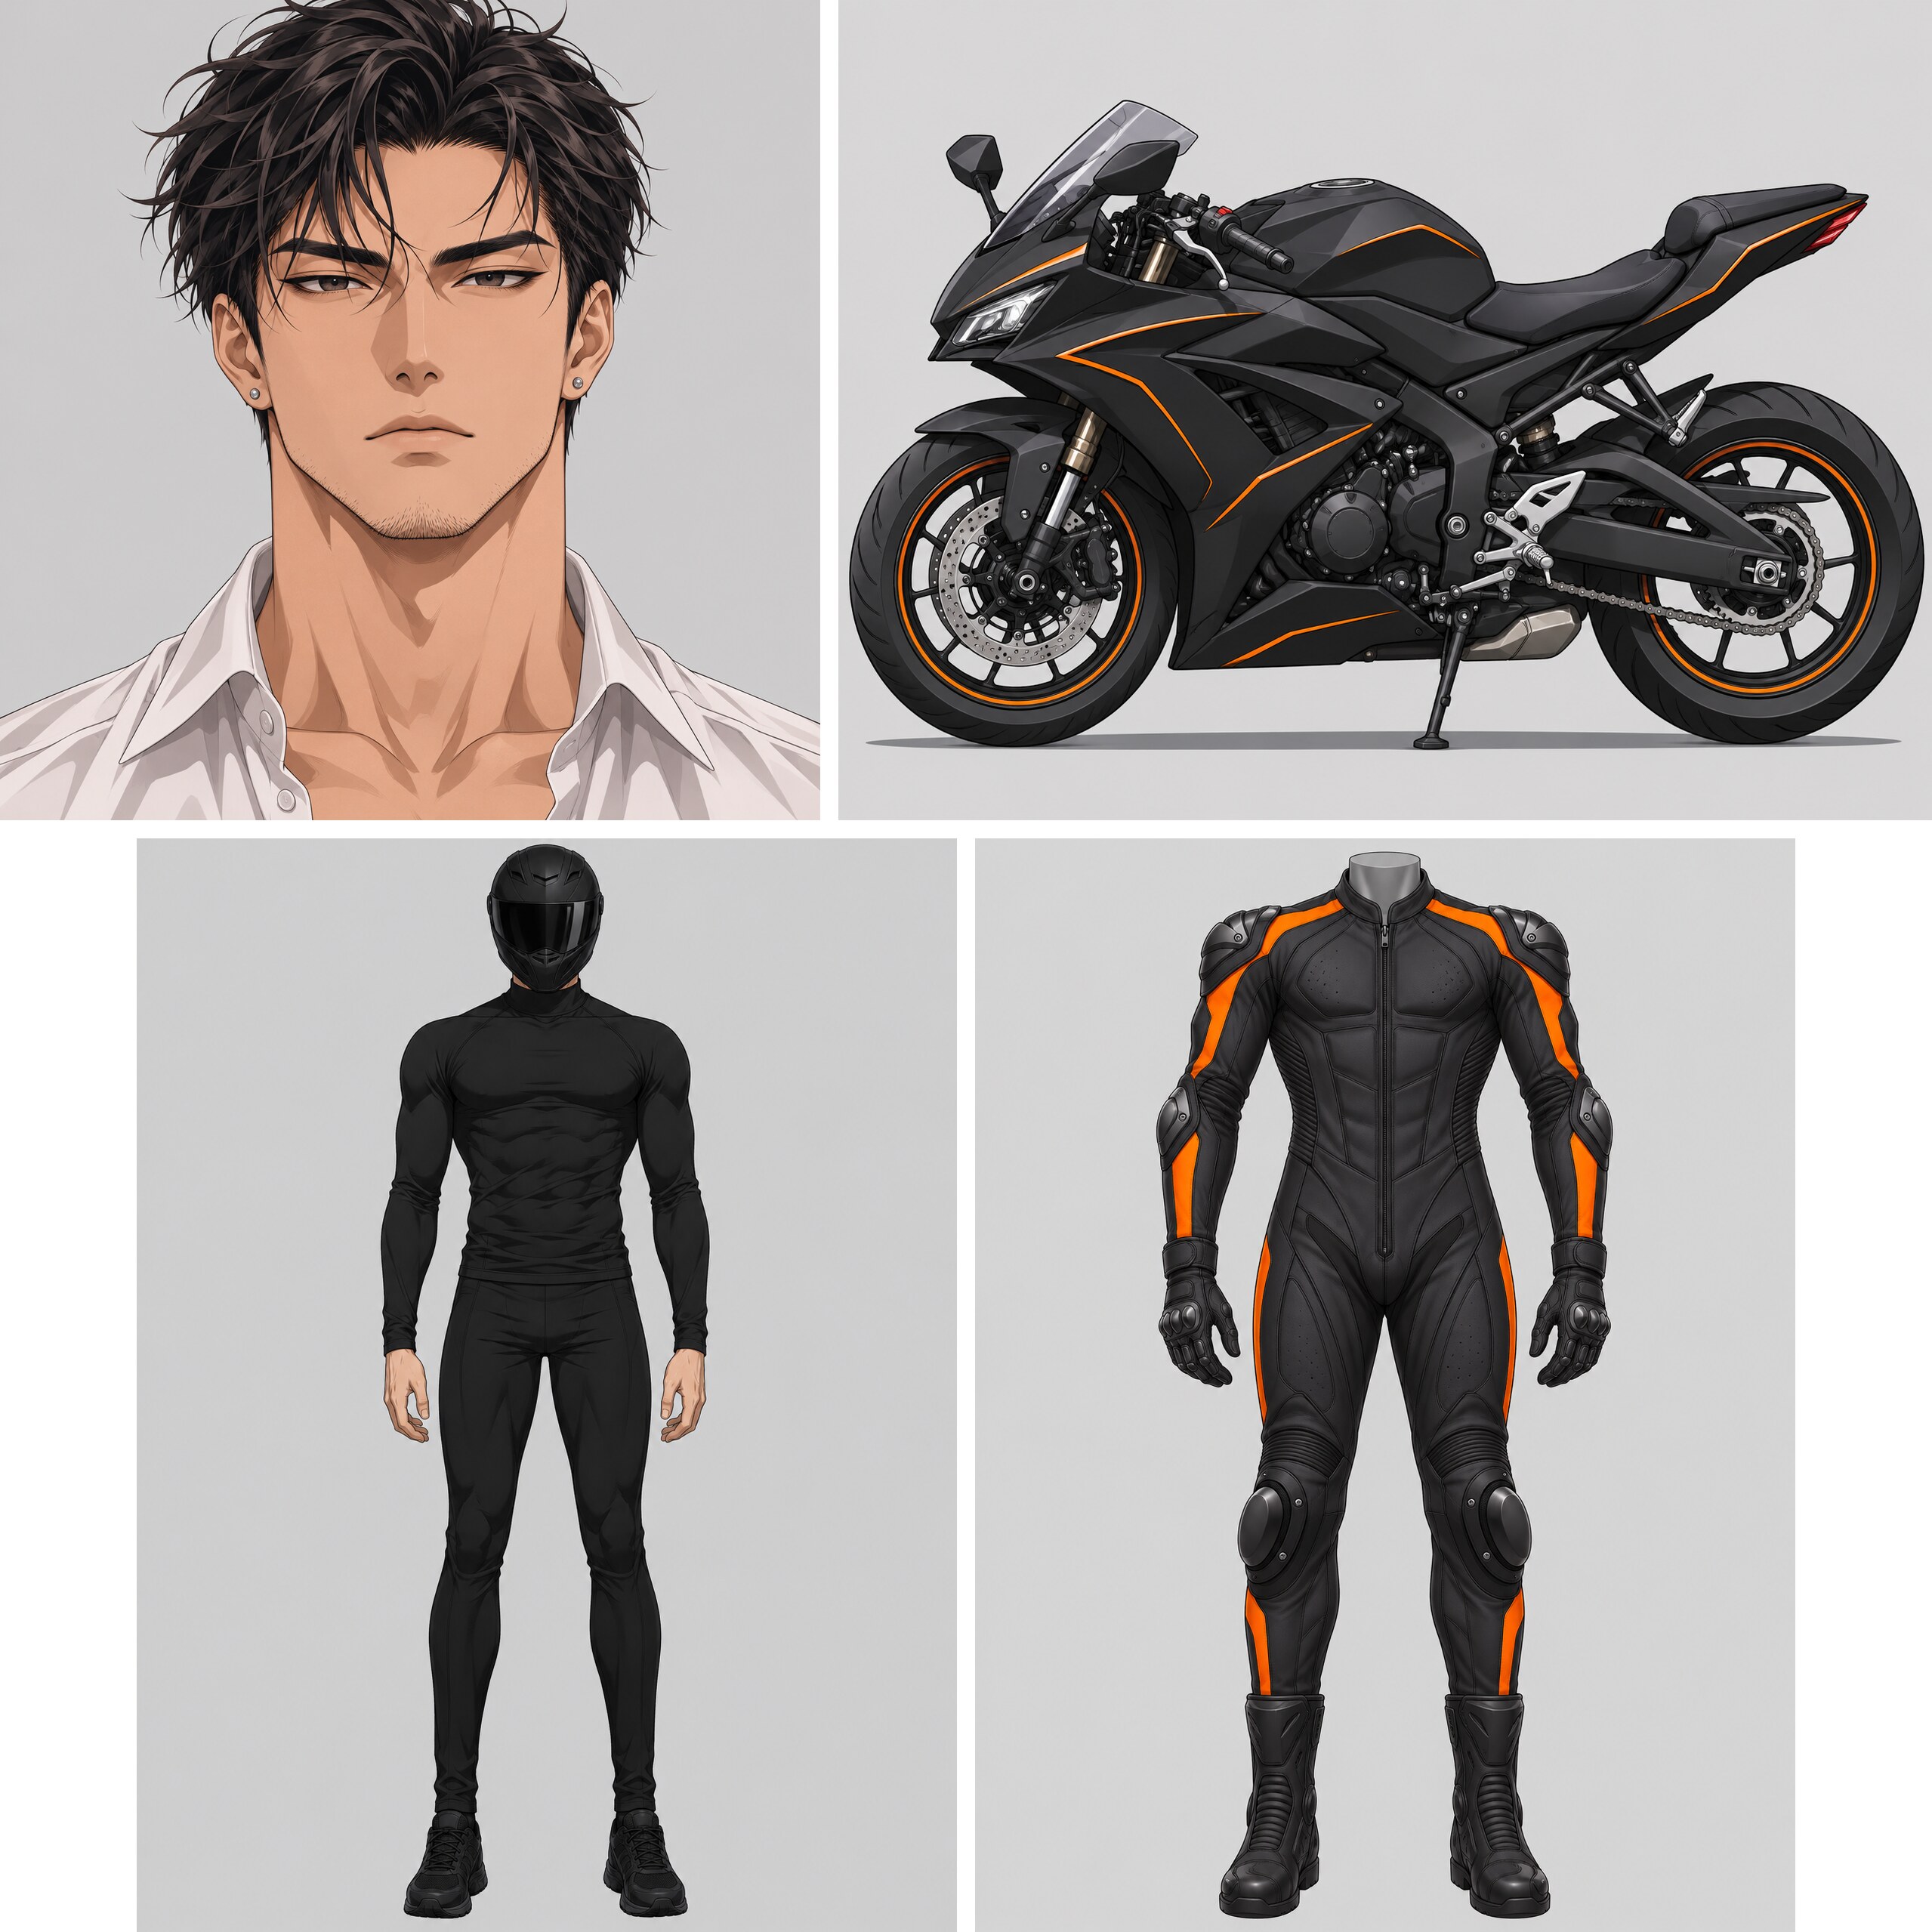
身材那张故意戴了头盔,骑行服穿在没有头的人台上。这样组合的时候,画面里只有一张脸可以用,不会把别的脸带进去。
然后按脸、身材、骑行服、摩托车的顺序上传4张,比例选4:3,提示词:
用上传的4张参考图生成同一个角色的设定卡。图1取脸、发型、眼睛和神态;图2只取身高、体型和身材比例,忽略头盔和衣服;图3取骑行服的款式、颜色、条纹和护具,忽略人台;图4取摩托车的车型、颜色和细节。构图:左边是他的全身正面站姿和全身背面站姿,中间上方是肩部以上的头像特写,右边是他的摩托车正侧面全车,车旁地上放着一顶哑光黑全盔。画面里只有这一个角色和这一辆车。手是五根手指。
后面接上那句共用的结尾。
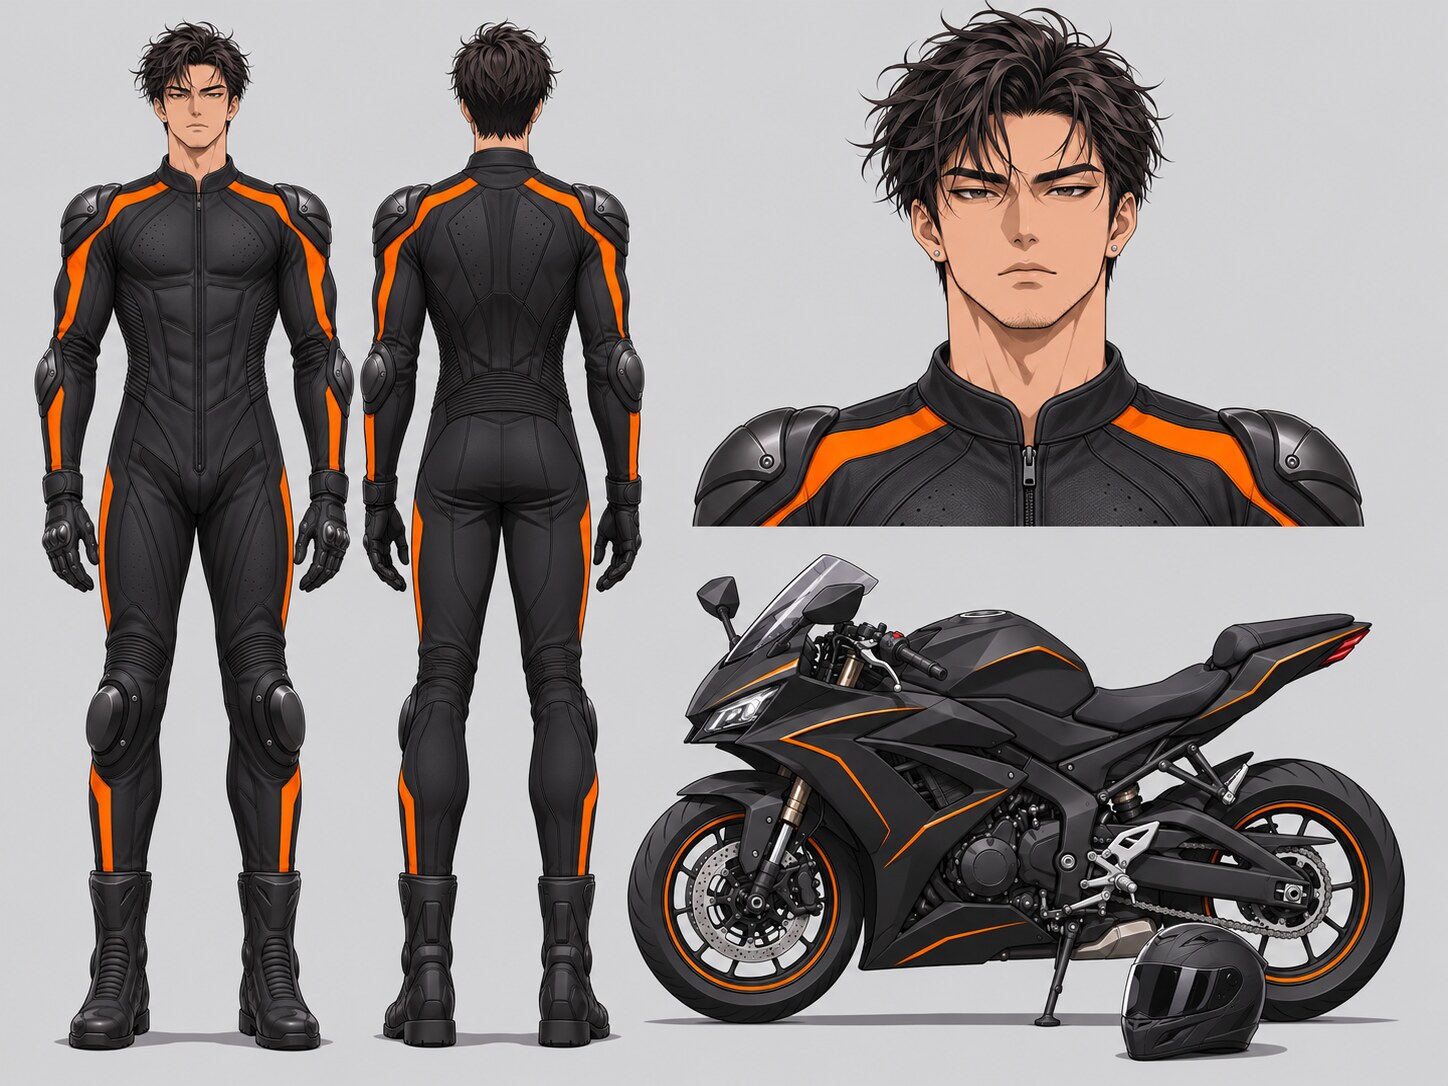
换一张脸、一套衣服、一辆车,提示词不动,就是另一个角色:
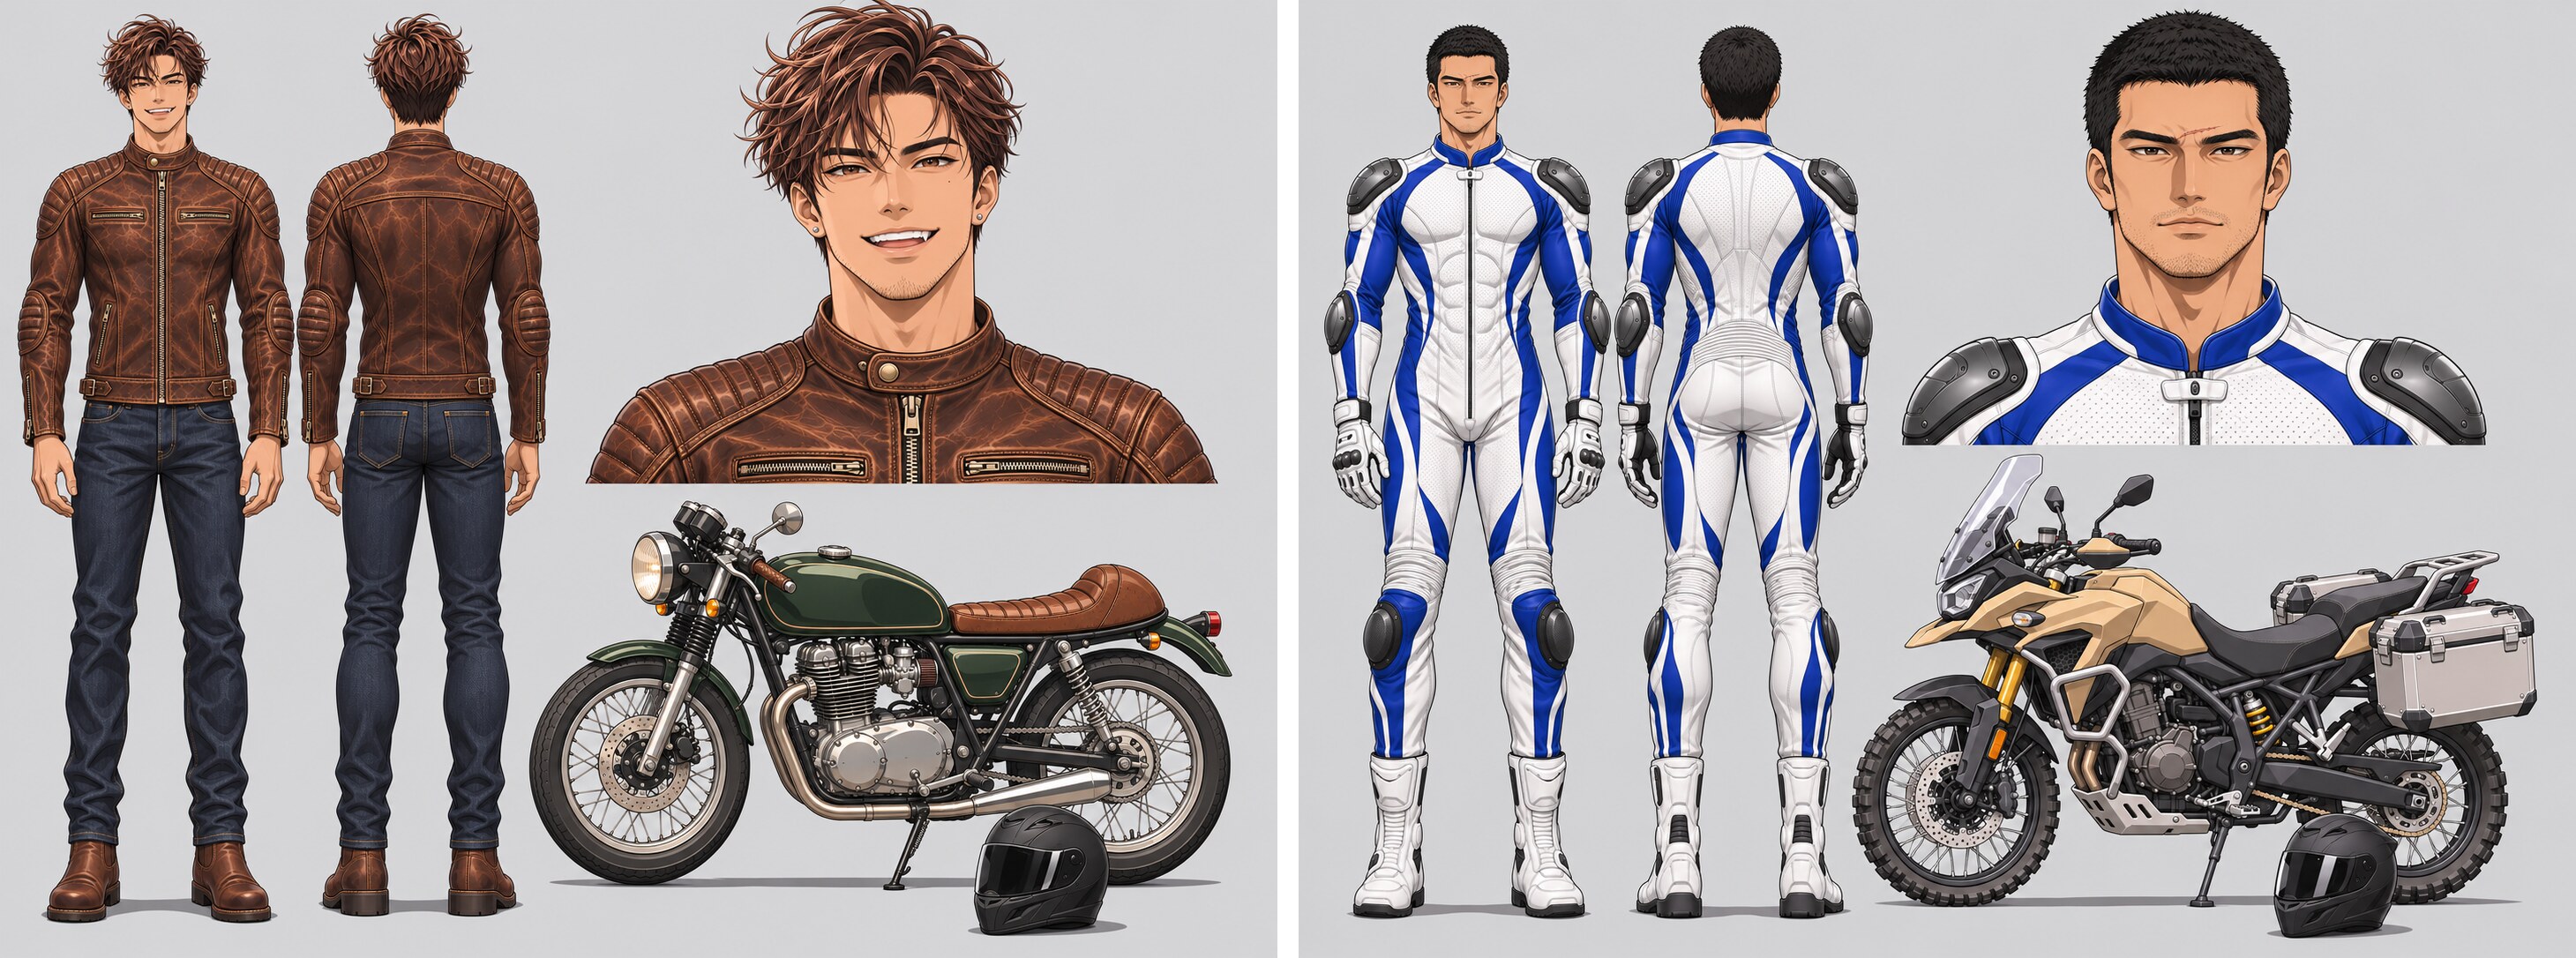
脸上的小特征都带过去了:虎牙、短胡茬、眉骨上的疤。衣服的条纹和车的颜色也对得上。
第5步:加一张姿势图,出成品画面
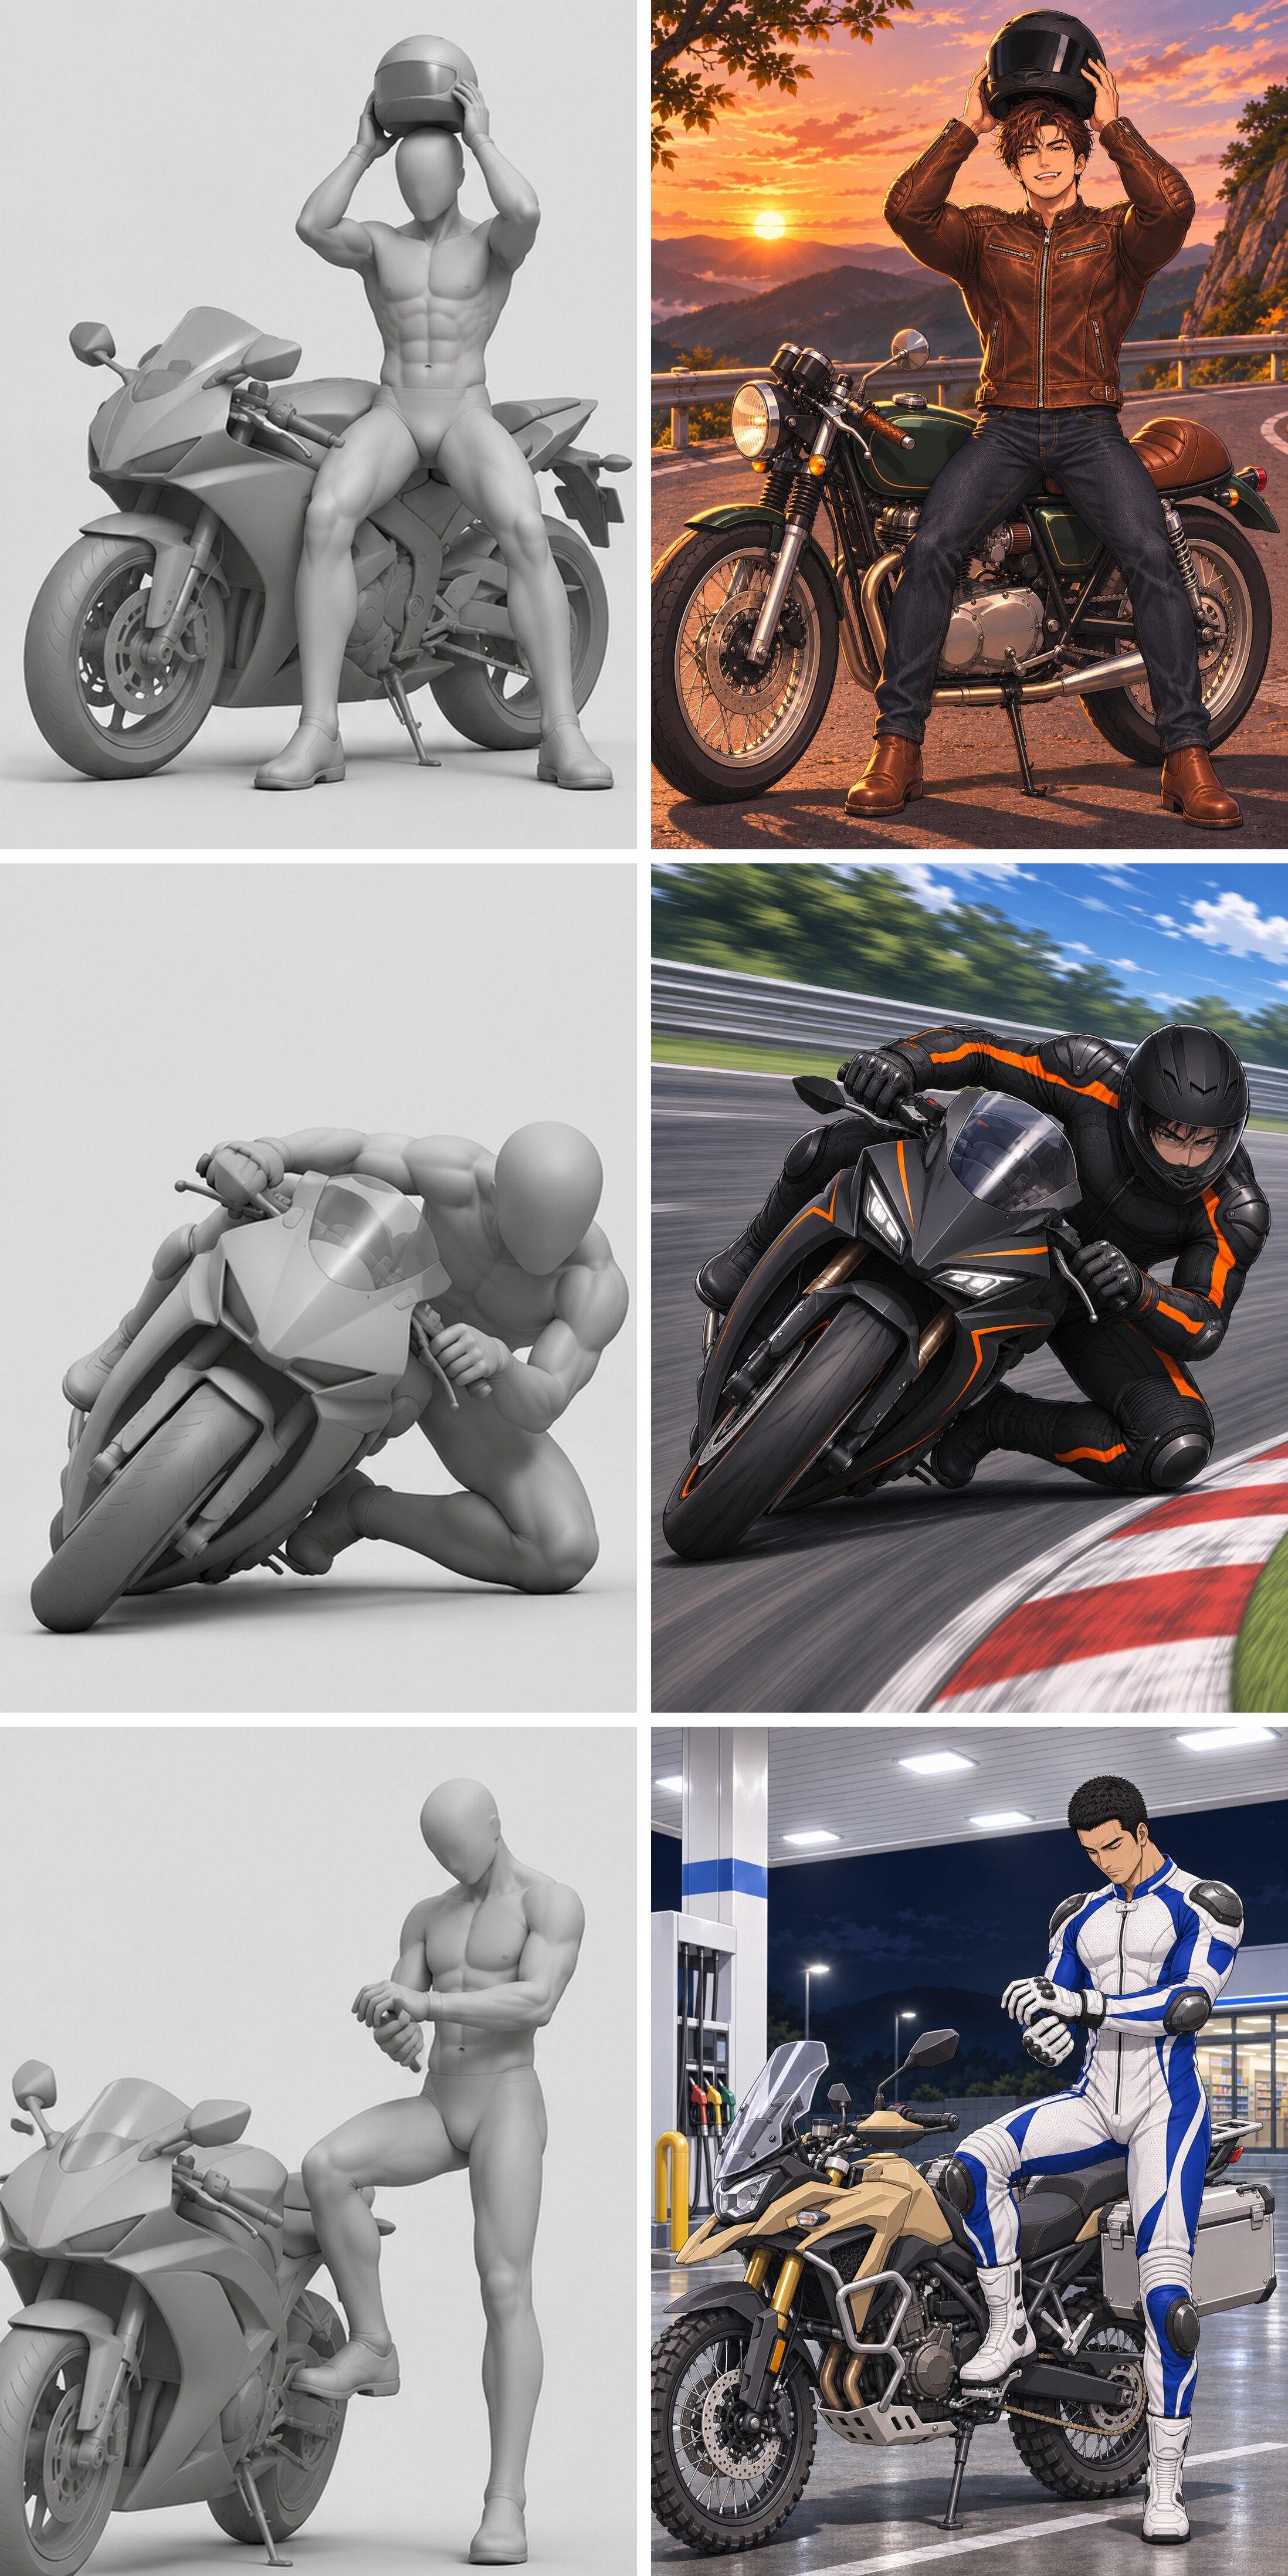
设定卡里的人都是站着的。到了具体镜头,他要压弯、要蹲下来修车,姿势光靠文字很难说准。
我们的做法是再加一张姿势图:一个灰色的人体模型摆出想要的动作。它也是文字生成的,比例3:4:
姿势参考图:一个没有五官、没有衣服细节的灰色3D人体模型,蹲在灰色素模摩托车的后轮旁,一只手扶着轮胎看链条。浅灰纯色背景,简单的3D渲染,不要文字。
然后按脸、身材、骑行服、摩托车、姿势的顺序上传5张,比例选3:4,提示词:
用上传的5张参考图生成一张画面。图1取脸、发型和神态;图2只取身高、体型和身材比例,忽略头盔和衣服;图3取骑行服的款式、颜色、条纹和护具,忽略人台;图4取摩托车的车型、颜色和细节;图5只取人物的姿势和动作,以及人和车的相对位置,忽略人体模型和素模车的颜色和材质。场景:车库,工具墙,暖黄色灯光。手是五根手指。不要文字和水印,任何地方都没有品牌标志和车牌号。画风:日系动漫,干净线稿,赛璐璐上色,均匀柔光,高细节。
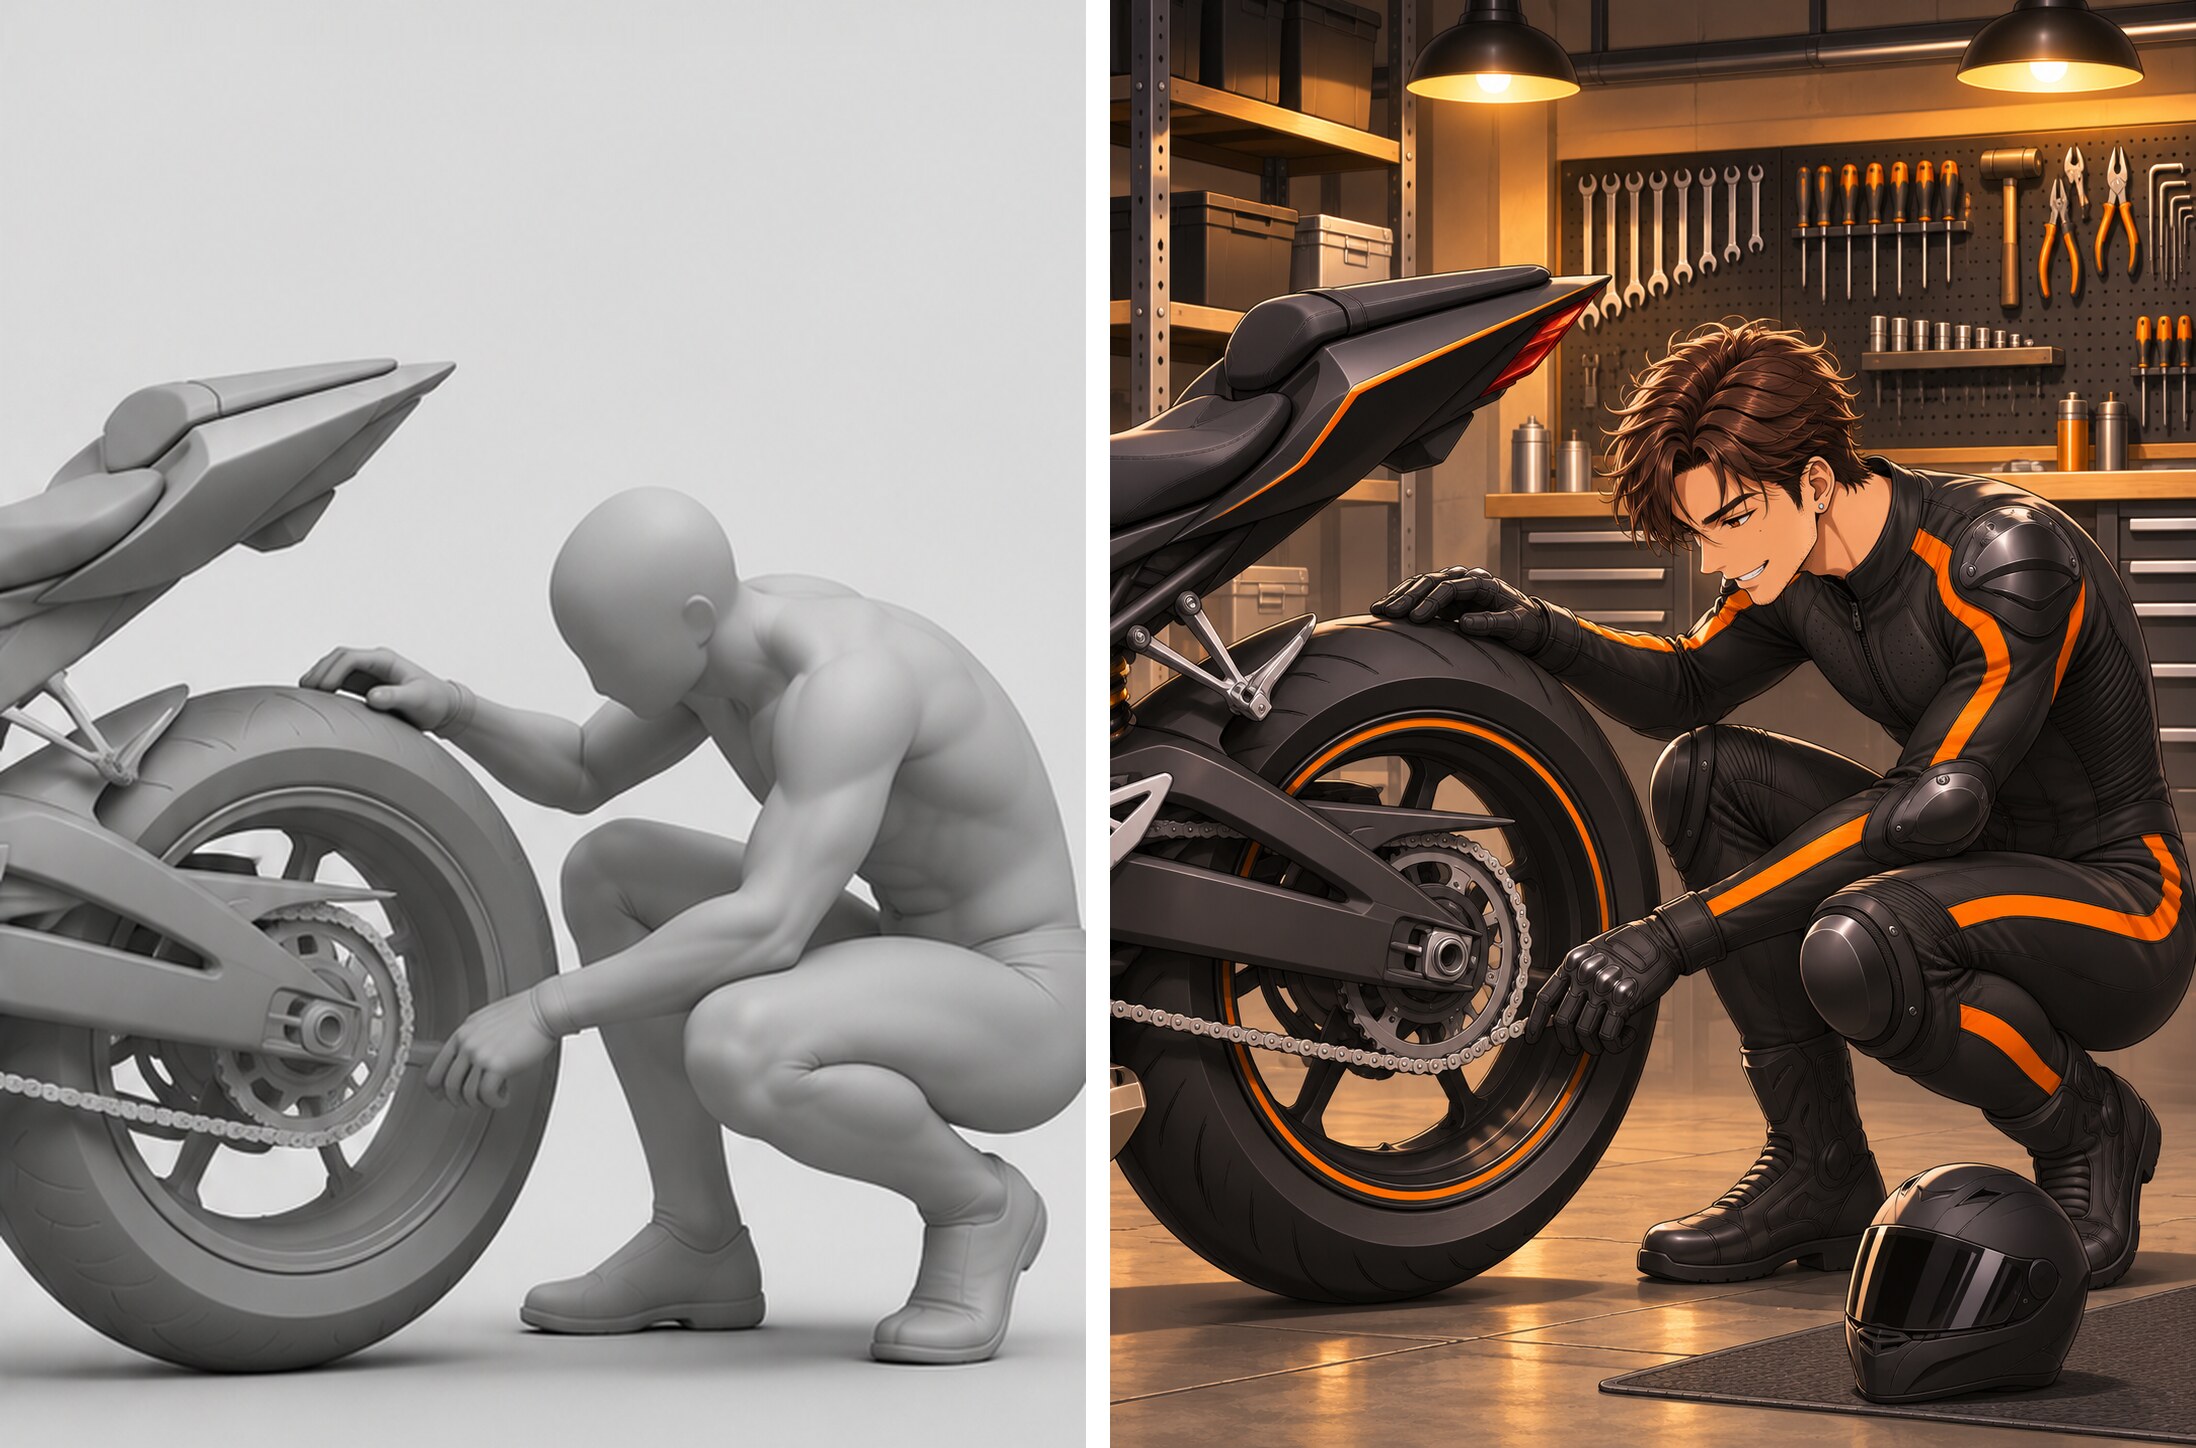
动作跟上了,人和车的位置也是照着姿势图来的。这张还换了一种搭法:棕发那张脸,配黑橙连体服和跑车。素材是分开的,想怎么搭就怎么搭。
换场景只改「场景:」后面那一句,换动作就换一张姿势图:
几点经验
- 脸最稳。发型、五官,还有虎牙和疤这类小特征,几次都带过去了。
- 衣服和道具稳。款式、颜色、条纹对得上。前提是它们各有一张干净的素材图。
- 侧脸要多写一句。只写「90度侧脸」,头常常只转大半,另一只眼睛还看得见。加上「画面中只能看到一只眼睛,看不到另一侧的眼睛和脸颊」会好很多。
常见问题
AI漫剧为什么要先做人物三视图? 模型每次出图都是重新画一遍。没有参考,同一个角色在不同镜头里就会长得不一样。三视图把正面、侧面、背面定在一张图上,之后每个镜头都拿它当参考图,人物才稳得住。
人物三视图的提示词怎么写? 写清四件事:哪几个视角、按什么顺序排;同一个人、同样的站姿和身高比例;纯色背景和均匀的光;不要文字、标签和场景。有参考照片的话,加一句「以上传的照片作为唯一的人物参考」。
三视图和四视图有什么区别? 三视图是正面、侧面、背面。四视图多一个角度,常见的是左右两个侧面,或者加一个3/4侧面。角色左右不对称,比如一边有疤、一边背着东西,就用四视图。
可以用真人照片吗? 可以,做法和第1步一样。请只用你自己的照片,或者得到本人同意的照片。
想试试?打开AI图片生成器,切到图片生成图片,把参考图按顺序放进去就可以开始。
- 人物三视图
- AI漫剧
- 角色三视图
- 四视图
- 人物一致性